EDA Open Source Models
EDA领域正迎来人工智能(AI)与大语言模型(Large Language Models,LLM)的深度融合革命。传统EDA流程高度依赖人工经验和复杂工具链,而开源EDA大模型项目通过引入LLM、Agent和专用数据集,实现了从RTL代码生成、物理设计优化到端到端自动化设计的智能化跃迁。这些项目不仅降低了芯片设计门槛,还为学术研究和工业应用提供了可复现、可扩展的基础设施。目前已经有“开源的 EDA 大模型/领域模型”了,但整体还处在「早期探索 + 强任务定向」阶段。
一、已经存在的「开源 EDA / 硬件大模型(Model 本体)」
目前开源社区的模型更倾向于“单点突破”,而非追求大而全。
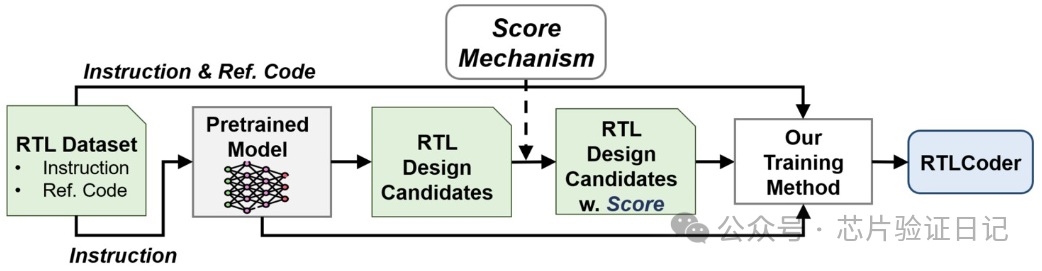
1. RTLCoder
- 定位:面向 Verilog / RTL 自动生成。
- 规模与特点:7B 参数规模,支持量化到 4bit 并在本地流畅运行。专门为 RTL Generation 设计,提供了一套基于代码质量反馈的训练流程。
- 工程表现:性能不仅超越了 GPT-3.5,在部分 RTL Benchmark 上甚至逼近或超过了 GPT-4,是目前最明确面向工程可用的开源模型。
- 相关链接:https://github.com/hkust-zhiyao/RTL-Coder
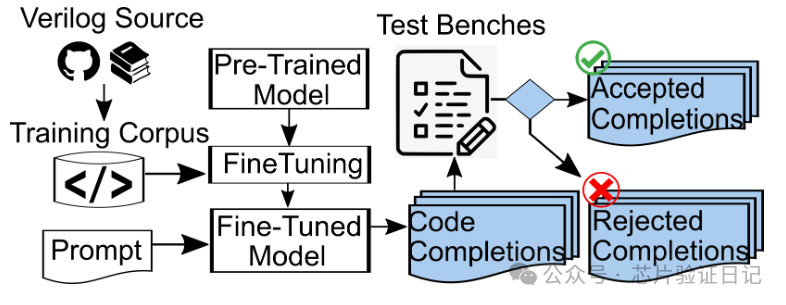
2. VGen(RTL 自动生成能力的基准与微调框架)
- 定位:LLM 生成 Verilog 代码的评估与提升框架。
- 特点:构建了包含 Testbench 功能分析和语法测试的综合评估框架,证明了经过特定语料微调的开源小模型在功能正确性上具备极强的竞争力。
- 相关链接:https://github.com/shailja-thakur/VGen
3. ChipExpert(垂直领域的全栈专家助手)
- 定位:集成电路设计领域的专属指令微调大模型。
- 特点:基于 Llama 3 微调,覆盖模拟、数字、射频、EDA 及 SoC 架构等 10 大专业方向,非常适合用作底层技术细节查询和前沿理论解答的基础知识引擎。
- 相关链接:https://github.com/NCTIE/ChipExpert
4. SemiKong(结合知识图谱的行业基座)
- 定位:半导体行业通用语言模型。
- 特点:采用独特的“双层架构”,在通用语言模型层之上内置了半导体本体论和知识图谱层,确保在处理复杂工艺和协议知识时具有极高的逻辑严密性。
- 相关链接:https://github.com/aitomatic/semikong
5. Hardware Phi‑1.5B(硬件领域预训练模型)
- 定位:通用 Hardware / Chip Design 领域 LLM。
- 特点:小而精(1.5B),在硬件专业语料上从头做领域预训练。偏向基座模型,非常适合在此基础上二次微调,搭建专属的“EDA Copilot”。
- 相关链接:https://arxiv.org/html/2402.01728v1
二、全链路自动化与智能代理 (Agent)
单点代码生成之外,行业也在积极探索如何用自然语言驱动整个 EDA 工具链。
1. OpenROAD-Agent(自我纠错脚本生成器)
- 定位:深度集成于 OpenROAD 的智能代理。
- 特点:基于 Qwen2.5-Coder,能够自主生成并执行 Python 代码,且具备根据工具反馈动态修正错误的闭环能力。
- 相关链接:https://github.com/OpenROAD-Assistant/OpenROAD-Agent
2. MCP4EDA(基于模型上下文协议的全局自动化)
- 定位:统一的 EDA 工具 API 交互层。
- 特点:打通了 Yosys、Icarus Verilog、OpenLane 等开源工具链。AI 助手可以直接调用本地工具,完成从 RTL 到 GDSII 的自动化闭环及 PPA 报告分析。
- 相关链接:https://github.com/NellyW8/MCP4EDA
3. AiEDA(AI 原生 EDA 底层库)
- 定位:面向 Design-to-Vector 的底层执行引擎。
- 特点:标准化 Python API,解决“设计数据向量化”难题,为线长预测、延迟预测等底层任务提供数据流水线。
- 相关链接:https://github.com/OSCC-Project/AiEDA
4. NL2GDS(全开源 Flow 演示)
- 定位:自然语言驱动的 OpenLane/OpenROAD 全流程。
- 特点:展示了从文本到 GDS 的完整打通,非常适合做 AI + OpenEDA 的架构参考与二次开发。
- 相关链接:https://arxiv.org/html/2603.05489v1
三、比“模型”更成熟的:开源数据集
💡 核心洞察: 目前 EDA AI 化的最大瓶颈根本不是算法模型,而是“可公开的高质量数据”。构建高质量数据集,本质上是在为 EDA 领域创造“ImageNet 时刻”。
1. EDA Corpus(目前最核心的开源 EDA 语料库)
- 背景:专为 OpenROAD 与 Physical Design 打造。
- 内容:包含高质量的 EDA Q&A(概念、错误、参数解析)以及 Prompt 到 TCL/Python script 的映射,规模达 1500+ 高质量样本。
- 相关链接:https://github.com/OpenROAD-Assistant/EDA-Corpus
2. OpenLLM‑RTL / RTLLM(Benchmark + Dataset)
- 定位:精准评估与训练 RTL 生成能力。
- 提供内容:自然语言 Spec、Golden RTL 以及对应的 Testbench,是对比与训练 LLM 硬件代码能力的基石。
- 相关链接:https://github.com/hkust-zhiyao/rtllm
总结: 这套基于开源生态的玩法已经初步成型。感兴趣的朋友可以进一步尝试。