2.2 PairHMM
论文中的 Pairwise Hidden Markov Model (PairHMM) 是基因组测序分析中 变异检测(variant calling) 阶段的核心动态规划算法。它用于把测序读段(reads)比对到候选单倍型(haplotypes)上,计算每种候选单倍型产生这些 reads 的似然概率,从而找出最可能的真实序列。
下面从背景、HMM 原理、PairHMM 算法、计算特征、GenDP 加速方式几个方面详细解释。
1. PairHMM 在基因组流程中的位置
论文 2.1 节提到:
- 测序得到 reads;
- 先把 reads 比对到参考基因组(read alignment),例如用 BSW;
- 比对后,reads 中仍然存在小变异(mutations);
- 下一步是 variant calling,即检测这些变异。
在 variant calling 中,常用工具如 GATK HaplotypeCaller 会:
- 在某个局部区域,通过 De-Bruijn 图遍历,生成若干候选单倍型(haplotypes);
- 对每条 read,计算它由每个候选单倍型产生的概率;
- 选择概率最大的单倍型作为该区域的真实序列。
第 2 步就是 PairHMM 的任务:给定一条 read 和一个候选 haplotype,计算它们之间的似然得分。这个得分反映了 read 与 haplotype 的匹配程度。
2. 什么是隐马尔可夫模型(HMM)?
HMM 是一种统计模型,包含:
- 隐藏状态:我们观察不到,但系统内部所处的状态;
- 观测值:我们能看到的数据;
- 状态转移概率:从一个隐藏状态转移到另一个状态的概率;
- 发射概率:在某个隐藏状态下,产生某个观测值的概率。
在 PairHMM 中:
- 隐藏状态:read 和 haplotype 之间的比对关系,即当前是匹配(M)、插入(I)还是缺失(D);
- 观测值:read 和 haplotype 上的碱基(A、C、G、T);
- 转移概率:从一个比对状态转移到另一个状态的概率,例如从匹配变为插入;
- 发射概率:在某个状态下,观察到特定碱基对的概率。
3. PairHMM 的状态与转移
PairHMM 通常有三个状态:
- M(Match):read 的当前碱基与 haplotype 的当前碱基对齐(可能相同也可能不同,但处于匹配状态);
- I(Insertion):read 的当前碱基相对于 haplotype 是插入;
- D(Deletion):haplotype 的当前碱基相对于 read 是缺失(即 read 中缺少对应碱基)。
论文 Figure 2b 展示了 PairHMM 的递推数据流。其中:
- 分别表示匹配、插入、缺失状态的概率;
- 是 HMM 的转移和发射参数;
- 是发射碱基 和 的先验概率。
一个典型的 PairHMM 递推公式如下(论文 Figure 2b 的简化版):
其中:
- 是 read 的位置, 是 haplotype 的位置;
- 表示从状态 X 转移到状态 Y 的概率;
- 是发射概率,通常基于碱基质量值计算。
最终,PairHMM 计算的是整条 read 和整个 haplotype 的联合似然,通常取 或三态之和。
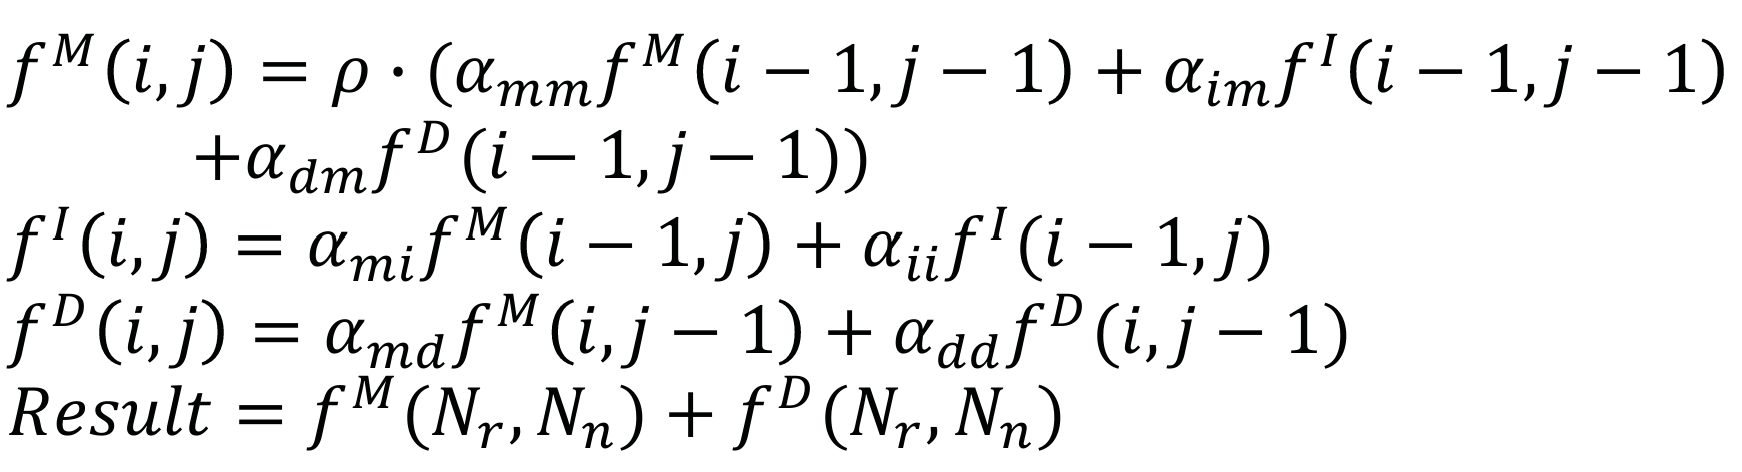
4. PairHMM 与动态规划的关系
PairHMM 的计算过程本质上是一个 二维动态规划:
- 状态是 ,表示 read 的前 个碱基和 haplotype 的前 个碱基;
- 每个单元格 、、 依赖前一个波前的数据;
- 递推方向类似于 Smith-Waterman,但计算的是概率(浮点数),而不是整数得分。
论文 Table 1 给出 PairHMM 的特征:
| 特征 | 值 |
|---|---|
| 维度 | 2D DP 表 |
| 大小 | 约 |
| 依赖 | 最后 2 个 wavefront |
| 精度 | 浮点数 |
- 2D DP 表:因为要同时沿 read 和 haplotype 两个方向递推;
- 约 :短读长约 100,haplotype 窗口约 60;
- 最后 2 个 wavefront:和 BSW 类似,当前波前只依赖前两个波前,适合波前并行;
- 浮点数:概率值通常很小,需要浮点精度,论文说 PairHMM 使用 floating-point arithmetic。
5. 为什么 PairHMM 计算量大?
在 GATK HaplotypeCaller 中:
- 一个局部区域可能生成多个候选 haplotype;
- 每条 read 都要和每个候选 haplotype 做 PairHMM;
- read 数量可能成千上万,haplotype 也有多个。
因此,PairHMM 的计算量非常大。论文 2.3 节指出,PairHMM 在对应的测序流程阶段中花费约 70% 的时间。
为了加速,实际实现中常采用 pruning(剪枝) 技术:在 DP 表中提前终止那些概率极低的路径,只计算有希望的单元格。论文 6 节提到,GenDP 评估的是 pruning-based implementation,其中 scan 阶段占 97.7%,剩余 2.3% 的重新计算在 CPU 上完成。
6. GenDP 如何加速 PairHMM?
论文中 GenDP 对 PairHMM 的支持包括:
6.1 浮点 PE 阵列
DPAx 架构中有一个专门的 浮点 PE 阵列,因为 PairHMM 需要浮点运算。整数 PE 阵列则用于 BSW、POA、Chain 等。
6.2 可编程计算单元
PairHMM 的目标函数包含多个乘加运算(如图 7b 的 reduction data-flow)。GenDP 的计算单元采用 2 级 ALU reduction tree,适合这种归约模式。每个 PE 是 2-way VLIW,可以并行执行两个计算指令。
6.3 对数与定点近似
论文 7.2 节提到:
The PairHMM baseline applies floating point, whereas GenDP applies the pruned-based implementation using logarithm and fixed point numbers to approximate the computation and reduce complexity.
也就是说,GenDP 并没有直接用浮点算所有东西,而是用 对数域 + 定点数 来近似概率计算,从而降低硬件复杂度,同时保持精度。这是一种常见的 PairHMM 优化:把乘法变成加法,把小数变成定点整数。
6.4 DPMap 映射
DPMap 算法把 PairHMM 的目标函数数据流图划分成子图,映射到 PE 内的 ALU 阵列。Figure 7b 展示了 PairHMM 的归约数据流,DPMap 会据此生成计算指令。
6.5 依赖模式支持
PairHMM 是 2D DP 表,依赖最后两个 wavefront。DPAx 的 PE 阵列通过 systolic 数据流和 FIFO 支持这种波前并行。每个 PE 负责一行,query 序列流经 PE,目标序列静态存储。相邻 PE 之间传递上方和对角线依赖数据。
7. 与其他 kernel 的对比
| Kernel | 维度 | 依赖 | 精度 | 在流程中的作用 |
|---|---|---|---|---|
| BSW | 2D | 最后 2 波前 | 8/16-bit 整数 | read alignment |
| PairHMM | 2D | 最后 2 波前 | 浮点 | variant calling |
| POA | 2D | 图结构、长距离 | 32-bit 整数 | 组装抛光 |
| Chain | 1D | 前 N 个锚点 | 32-bit 整数/浮点 | 长读重叠 |
PairHMM 的独特之处在于:
- 需要浮点或高精度定点;
- 计算的是概率似然,而不是相似性得分;
- 在 variant calling 中占主导时间;
- 常用剪枝优化,GenDP 支持这种剪枝实现。
8. 一句话理解 PairHMM
PairHMM 是一种基于隐马尔可夫模型的二维动态规划算法,用于计算一条测序 read 由某个候选 haplotype 产生的似然概率。
它有三个状态(匹配、插入、缺失),依赖前两个波前,使用浮点运算,是变异检测中最耗时的步骤之一。GenDP 通过浮点 PE、可编程计算单元、对数/定点近似和波前并行,高效地加速 PairHMM。