3.3 Phase 2 of TALCO algorithm
这个问题问得很关键。答案是:
Phase 2 往后算多少个 frontier,不是固定的,而是动态的。
它从 marker 开始,一直往后算,直到收敛或者到达比对末尾。
收敛得快,就少算几个;收敛得慢,就多算很多个。
下面详细解释。
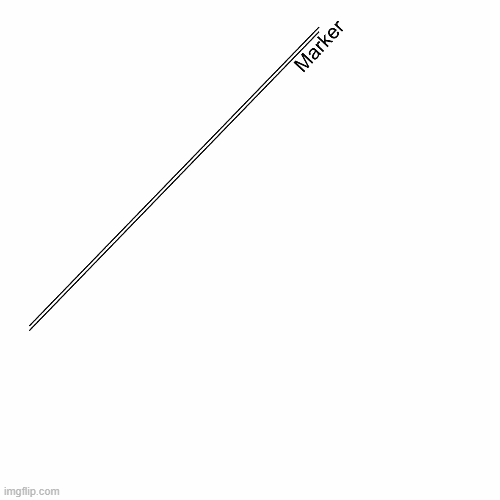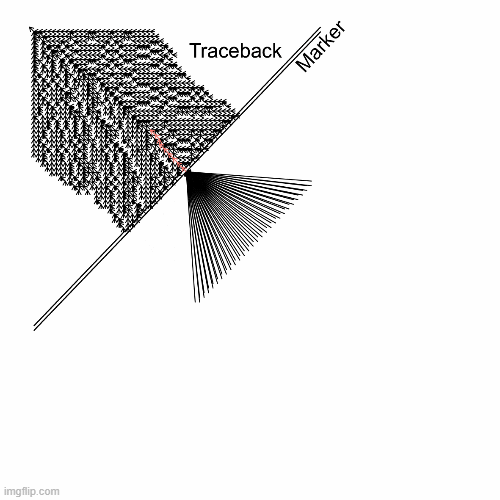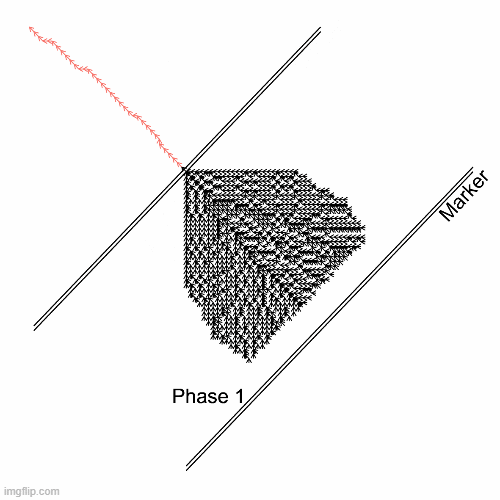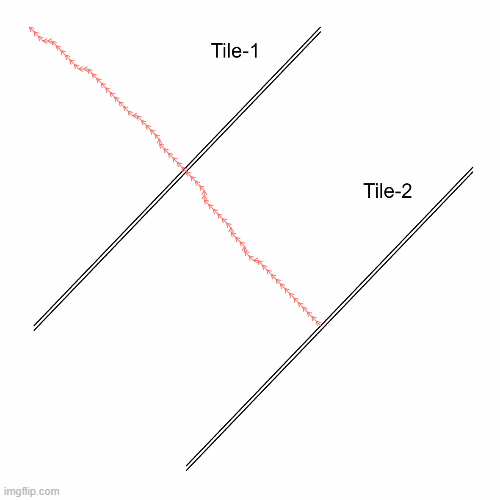
1. 先回顾 tile 的结构
每个 tile 在 Phase 1 中推进 M 个 frontier:
- tile 从 frontier 开始;
- Phase 1 计算 ;
- 其中 就是 marker。
Phase 1 结束后,外层循环会执行:
i ← i + M
所以下一个 tile 从 开始。
注意:下一个 tile 的起点是 marker 之后的下一个 frontier,而不是 marker 本身。
2. Phase 2 从 marker 之后开始算
Phase 2 的条件是:
if j - i >= M then
当 时,就已经超过 marker 了,进入 Phase 2。
也就是说,Phase 2 从 marker 的下一个 frontier 开始往后算。
然后 Phase 2 每轮做:
- 计算当前 frontier 的 convergence pointer;
- 检查是否所有 convergence pointer 都指向 marker 上同一个格子;
- 如果收敛,就
break,Phase 2 结束; - 如果没收敛,就
ConvPrprev ← ConvPrcurr,然后j ← j + 1,继续算下一个 frontier。
所以 Phase 2 往后算的 frontier 数量是:
这个距离不是预先设定的,而是由数据决定的。
3. 三种终止情况
Phase 2 会在以下三种情况之一停止:
情况 A:收敛了
当前 frontier 上所有格子的 convergence pointer 都指向 marker 上的同一个格子 。
此时:
Phase 2 结束。
这是最理想的情况,Phase 2 算的 frontier 很少,冗余计算小。
情况 B:到达比对末尾
如果一直不收敛,但已经算到序列末尾,那么:
C_tb ← ConvPrlatt
break
其中 ConvPrlatt 是之前保存的、局部最大分格子 Clast 对应的 convergence pointer。
Phase 2 结束。
情况 C:wavefront 超过硬件限制
如果某个 frontier 的 cell 数超过硬件预设的 ,硬件返回 invalid flag,Host CPU 用软件重新算。
这不属于 Phase 2 正常终止,而是硬件回退。
4. Phase 2 算的 frontier 是冗余的
关键点:Phase 2 算的这些 frontier,会在下一个 tile 中重新计算。
为什么?
- 下一个 tile 从 开始;
- 而 Phase 2 可能算到了 ;
- 这些 frontier 在下一个 tile 的 Phase 1 中会再次被计算。
所以 Phase 2 的计算是冗余计算,目的是为了找到收敛点,保证正确性。
收敛越快,冗余越少,效率越高。
5. 效率怎么衡量?
论文定义效率为:
Phase 1 计算的 frontier 数 / 总 frontier 数
如果 Phase 2 平均只多算 个 frontier,那么每个 tile 总共算 个 frontier,其中只有 个是 Phase 1 的有效计算。
效率:
论文实测:
- 低错误率 时,效率 ;
- 最差情况也超过 。
这意味着 Phase 2 平均只多算:
- 高效率时:;
- 最差时:。
相比之下,GACT 固定重叠导致效率通常只有 或更低。
6. 一个直观例子
假设 ,即每个 tile Phase 1 算 100 个 frontier。
情况 1:很快收敛
- Phase 2 从 开始算;
- 算到 就收敛了;
- Phase 2 多算 3 个 frontier;
- 效率:
情况 2:中等速度收敛
- Phase 2 从 算到 才收敛;
- 多算 15 个 frontier;
- 效率:
情况 3:一直不收敛
- Phase 2 从 一直算到序列末尾;
- 假设末尾是 ;
- 多算 400 个 frontier;
- 效率:
这种情况效率很低,但算法仍然正确。
论文说最差情况超过 85%,说明实际数据中很少出现完全无法收敛的情况。
7. 为什么可以这样设计?
因为 TALCO 的核心保证是:
只要找到收敛点,就能保证当前 tile 的回溯路径与完整算法一致。
所以 Phase 2 不需要预设“算多少个 frontier”,而是:
- 能收敛就早停,节省计算;
- 不能收敛就继续算,保证正确;
- 到末尾还不收敛,就用 fallback 处理。
这比 GACT 固定重叠更灵活:
- GACT 不管数据如何,都固定重叠 个格子,冗余固定;
- TALCO 根据数据自适应,收敛快时冗余少,收敛慢时冗余多,但绝不牺牲正确性。
8. 一句话总结
TALCO 的 Phase 2 从 marker 之后开始,一直往后算 frontier,直到所有 convergence pointer 汇聚到 marker 上同一个格子(收敛),或者到达比对末尾。Phase 2 算多少个 frontier 不是固定的,而是由数据动态决定:收敛越快,算得越少,冗余越小,效率越高。这些 Phase 2 的 frontier 会在下一个 tile 中重算,属于冗余计算,但保证了与完整 banded 算法结果一致。