2.3 POA
论文中的 Partial Order Alignment (POA) 是一种用于 基因组组装抛光(assembly polishing) 的动态规划算法。它的核心特点是:不再把参考序列看作一条线性序列,而是看作一个“偏序图”(partial-order graph),然后把每条新读段比对到这个图上,更新图的结构和权重,最终生成更准确的共识序列。
下面从背景、图结构、动态规划过程、长距离依赖、计算特征、GenDP 加速方式几个方面详细解释。
1. POA 在基因组流程中的位置
论文 2.1 节提到,基因组组装有两条路线:
- 参考引导组装:把 reads 比对到参考基因组;
- 从头组装(de novo assembly):没有参考基因组,直接用 reads 拼接。
从头组装时,先用 reads 之间的重叠关系构建一个 重叠图(overlap graph),再把重叠区域连接成更大的连续片段。但由于测序错误,组装结果中仍然存在错误。于是需要 抛光(polishing) 步骤来纠正这些错误。
POA 就是抛光阶段的核心算法。它把多条 reads 构建成一个 偏序图,然后用每条 read 去比对这张图,根据比对结果更新边的权重,最终推断出更可靠的共识序列。
论文 2.3 节指出,POA 在对应的组装抛光阶段中花费约 47% 的时间。
2. 什么是偏序图?
在传统的序列比对中,参考序列是一条线性的碱基序列,比如:
A C G T A C G T
而在 POA 中,参考不再是线性序列,而是一个 有向无环图(DAG),称为 偏序图。图中:
- 节点(node):代表一个碱基(A、C、G、T);
- 有向边(edge):表示两个碱基在某个 read 中相邻;
- 边权重(weight):表示这条边在不同 reads 中出现的次数。
例如,三条 reads:
A C G T
A C T
A G T
它们可以构建成如下的偏序图:
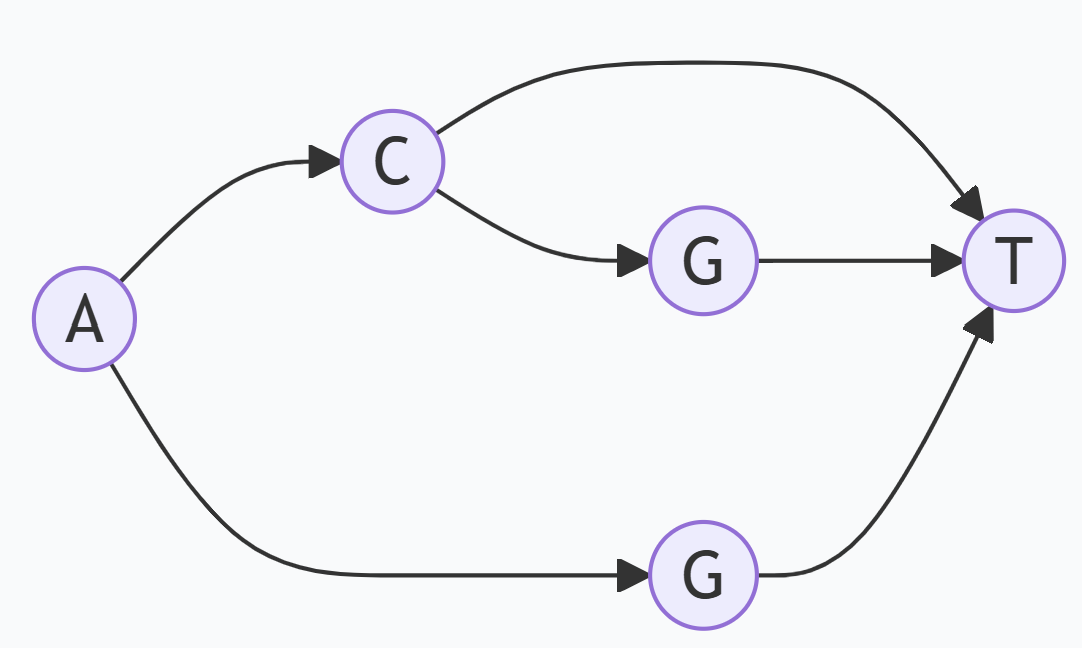
graph LR
    A((A)) --> C((C))
    A --> G2((G))
    C --> G1((G))
    C --> T((T))
    G1 --> T
    G2 --> T
更准确地说,图中有节点 A、C、G、T,边 A→C、C→G、G→T 等。如果多条 read 支持同一条边,该边的权重就高。图可以分叉(不同 read 在这里有不同的碱基),也可以合并(不同路径最终汇合到同一节点)。这种结构能表示多个 read 之间的差异和共识。
3. POA 的目标
POA 的目标是:把一条新的未比对 read 比对到已有的偏序图上,找到它在图中的最佳路径。然后根据这条 read 的路径,更新图中节点和边的权重。重复这个过程,图会越来越能代表所有 reads 的共识。
最终,从图中提取一条权重最高的路径,就得到 共识序列(consensus sequence)。
4. POA 的动态规划过程
POA 的比对过程仍然是一个二维动态规划,但和 BSW 有重要区别:
- 行(row):对应偏序图中的节点(或图上的位置);
- 列(column):对应新 read 的碱基;
- 单元格:表示新 read 的前 个碱基与图中某个节点 的比对得分。
每个单元格的得分通常类似于 BSW,考虑匹配、插入、缺失和 gap 罚分。论文 2.3 节说:
The objective function is similar to that used in BSW.
但关键在于依赖模式不同。
4.1 标准 BSW 的依赖
在 BSW 的 2D 表中,每个单元格 只依赖:
- 左边:
- 上边:
- 左上对角:
也就是只依赖前一行和当前行的相邻单元格。
4.2 POA 的依赖
在 POA 中,每个单元格不仅依赖上一行(图中的前驱节点),还依赖 图中与当前节点有边连接的其他行。论文 2.3 节说:
Each cell not only depends on the upper and diagonal cells in the previous row, but also depends on earlier rows if there is an edge connecting that row with the current row in the graph.
意思是:如果偏序图中有一条边从某个较早的节点指向当前节点,那么当前单元格就要依赖那个较早节点所在行的结果。这个较早节点可能离当前节点很远,因此形成了 长距离依赖(long-range dependency)。
Figure 2c 展示了 POA 的 DP 表。其中:
- 灰色格子是已经计算过的;
- 绿色格子是当前波前正在并行计算的;
- 蓝色圆圈表示单元格依赖;
- 橙色箭头表示来自其他行的长距离依赖。
5. 长距离依赖从何而来?
偏序图不是线性的,而是一个有向无环图。一个节点可能有多个前驱节点。例如:
    B —— D
  /       \
A          F
  \       /
    C —— E
节点 F 有两个前驱:D 和 E。当计算 F 对应的行时,它可能依赖 D 行和 E 行的结果。D 和 E 在图中可能相隔很远,在 DP 表中对应的行号差距也可能很大。
因此,POA 的依赖距离不是固定的 1 或 2,而是由图的拓扑结构决定的。这就是论文 Table 1 中写的:
| 特征 | 值 |
|---|---|
| 维度 | 2D 表 |
| 大小 | 约 |
| 依赖 | 图结构、长距离依赖 |
| 精度 | 32-bit 整数 |
6. POA 的计算特征
- DP 表更大:约 ,比 BSW 和 PairHMM 的 大很多,因为图可能包含很多节点,reads 也更长。
- 32-bit 整数:得分可能较大,需要 32 位精度。
- 图结构依赖:依赖关系不固定,需要根据图动态决定,控制复杂。
- 长距离依赖:需要保存较早行的结果,不能只保留前两个波前。
- 波前并行受限:因为依赖不规律,同一条波前上的单元格可能依赖不同行,并行度不如 BSW 规则。
论文 7.2 节指出,POA 在 GenDP 上的性能瓶颈是 内存访问:
- 图依赖信息需要从输入数据缓冲区加载到每个 PE;
- 回溯(trace-back)需要每个单元格的移动方向,每个单元格要输出 8 字节到输出缓冲区;
- 这些额外的数据移动指令限制了 POA 的性能。
论文 7.3 节还提到,POA 比其他三个 kernel 复杂得多,导致 GenDP 中 37.5% 的寄存器和 40% 的 SRAM 只被 POA 使用,在其他 kernel 中处于空闲状态。
7. GenDP 如何支持 POA?
GenDP 的 DPAx 架构通过以下机制支持 POA:
7.1 长距离依赖存储
每个 PE 内部有 scratchpad memory (SPM),用来存储长距离依赖的候选单元格结果。论文 3.1 节说:
Long-range dependencies in the graph structure are supported by scratchpad memories (SPM) inside each PE.
在普通 2D DP 表中,通常只需要在 PE 中保存左边单元格的结果。但在 POA 中,如果当前单元格依赖同一行但较远的其他单元格,就需要把所有候选依赖单元格存入 SPM,供后续重用。
GenDP 支持每行最多 128 个单元格距离 的长距离依赖。论文 6 节提到,少数超过 128 的超长依赖(由最后几条 read 中的超长缺失引起)占工作负载的 2.4%,这部分在主机 CPU 上执行。
7.2 解耦控制与计算
POA 的依赖模式由图结构决定,需要分支指令来控制数据移动。DPAx 采用 解耦访问/执行(decoupled access execute) 风格,把控制指令和计算指令分开:
- 控制线程管理 SPM、寄存器文件和相邻 PE 之间的 systolic 数据流;
- 计算线程执行目标函数计算。
这样可以灵活处理 POA 中不规则的依赖和数据移动。
7.3 DPMap 映射目标函数
POA 的目标函数与 BSW 类似,包含匹配、插入、缺失、取最大值等操作。DPMap 算法把目标函数的数据流图划分成子图,映射到 PE 内的 ALU 阵列。由于 POA 依赖复杂,DPMap 的分区规则需要满足计算单元的结构约束。
7.4 性能表现
论文 7.4 节 Table 11 显示,POA 的 VLIW 利用率只有 28.5%,是四个 kernel 中最低的。原因包括:
- 复杂依赖模式导致 14.3% 的 CU 空闲;
- 乘法和条件操作只能映射到 4 输入 ALU,限制了 VLIW 利用率;
- 回溯输出和依赖信息加载占用额外指令。
尽管如此,GenDP 仍然比 CPU 和 GPU 有显著加速。论文 Table 15 显示,POA 上 GenDP 相对 CPU 加速 ,相对 GPU 加速 。
8. POA 与 BSW 的对比
| 特性 | BSW | POA |
|---|---|---|
| 参考结构 | 线性序列 | 偏序图 |
| DP 表大小 | ~100×60 | ~1000×500 |
| 依赖 | 最后 2 个波前 | 图结构、长距离依赖 |
| 精度 | 8/16-bit 整数 | 32-bit 整数 |
| 控制复杂度 | 低,规则 | 高,不规则 |
| 并行度 | 高,波前并行 | 受限,依赖图结构 |
| 主要瓶颈 | 计算 | 内存访问、控制 |
9. 一句话理解 POA
Partial Order Alignment 是一种把新读段比对到偏序图上的动态规划算法,用于组装抛光。
它的 DP 表是二维的,但依赖关系由图结构决定,存在长距离依赖,计算不规则,控制复杂。GenDP 通过 PE 内的 SPM、解耦控制/计算、DPMap 映射和 systolic 数据流来支持 POA,尽管其 VLIW 利用率较低,但仍能获得显著的加速。
。